 Saepul Malik
Inspigo AI: Real-Time RAG untuk Pembelajaran Terpersonalisasi
Pengalaman chatbot streaming bertenaga OpenAI/Bedrock dan pipeline RAG, yang berpijak pada konten pembelajaran milik platform sendiri.
Masalah
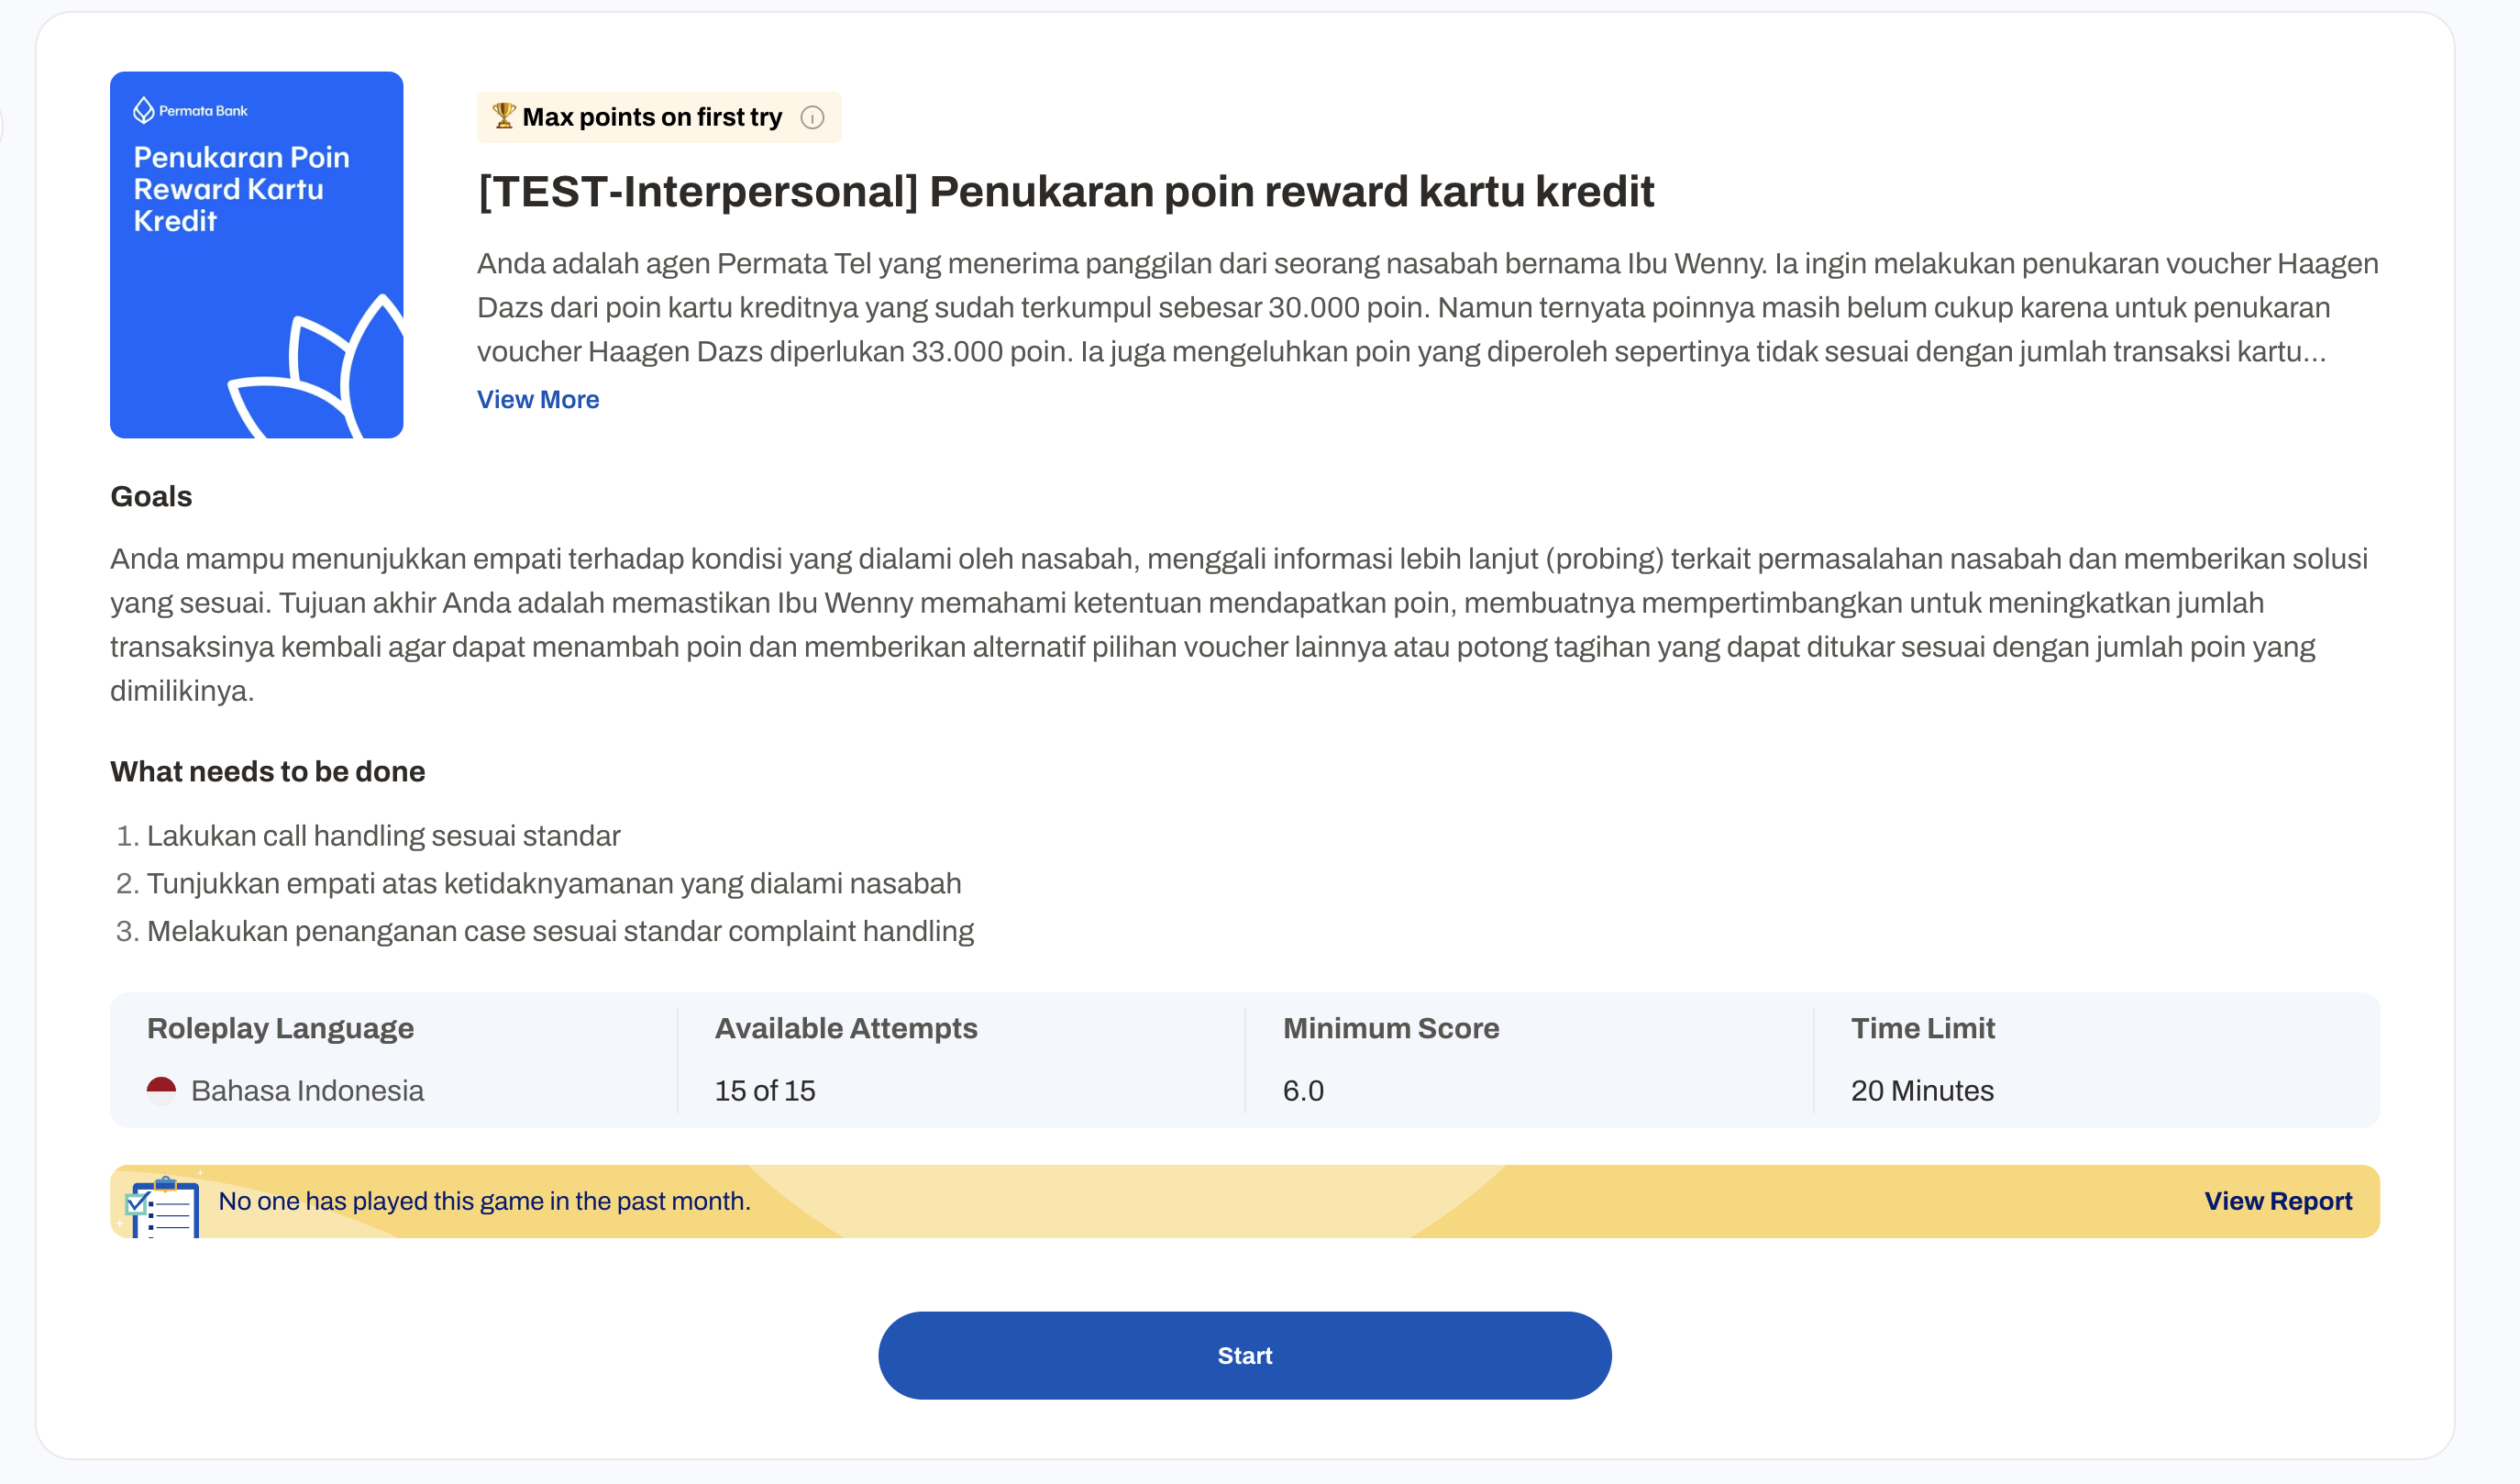
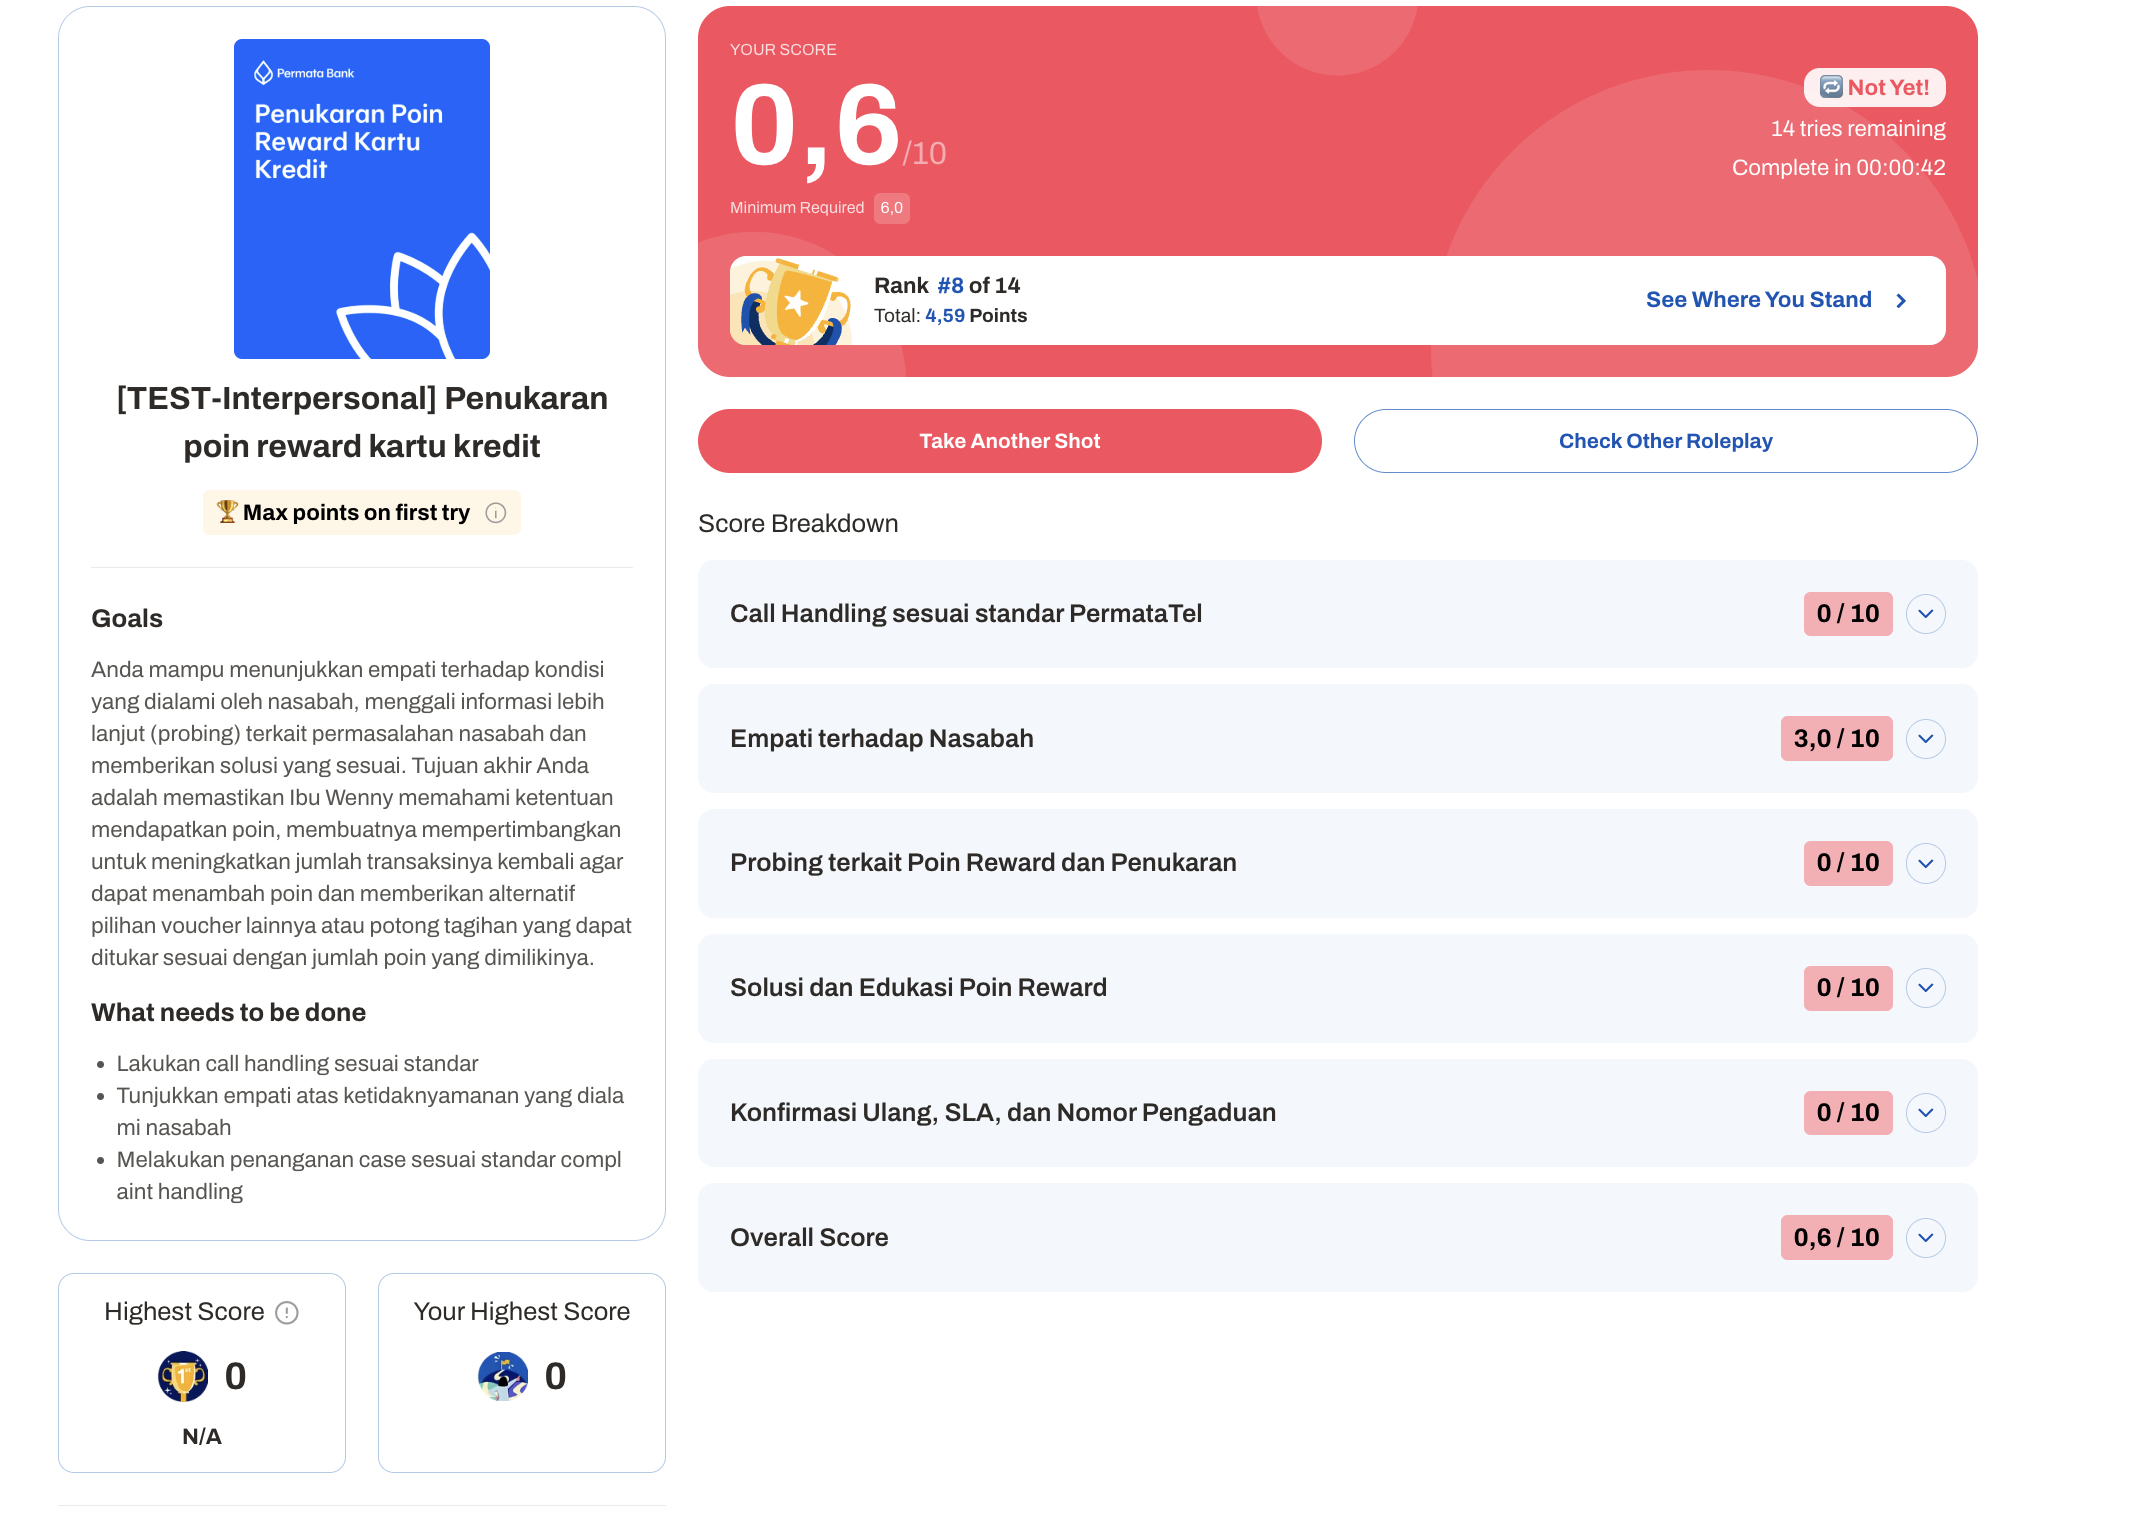
Pembelajaran terpersonalisasi jauh lebih efektif dengan bantuan berbasis percakapan yang memahami konteks ketimbang sekadar pencarian konten statis — namun foundation model yang menjawab murni dari data pelatihan umumnya tidak berpijak pada materi yang sebenarnya diajarkan oleh platform.
Arsitektur
Dokumen sumber diunggah melalui Inspigo CMS, disimpan di S3, dan di-ingest ke Pinecone sebagai vector store — Pinecone menangani chunking dan metadata, dengan embedding yang dihasilkan via model embedding OpenAI. Saat generation time, chunk yang diambil diinjeksikan ke dalam prompt sebelum model merespons. OpenAI adalah model utama, dengan AWS Bedrock sebagai fallback.
Eksekusi
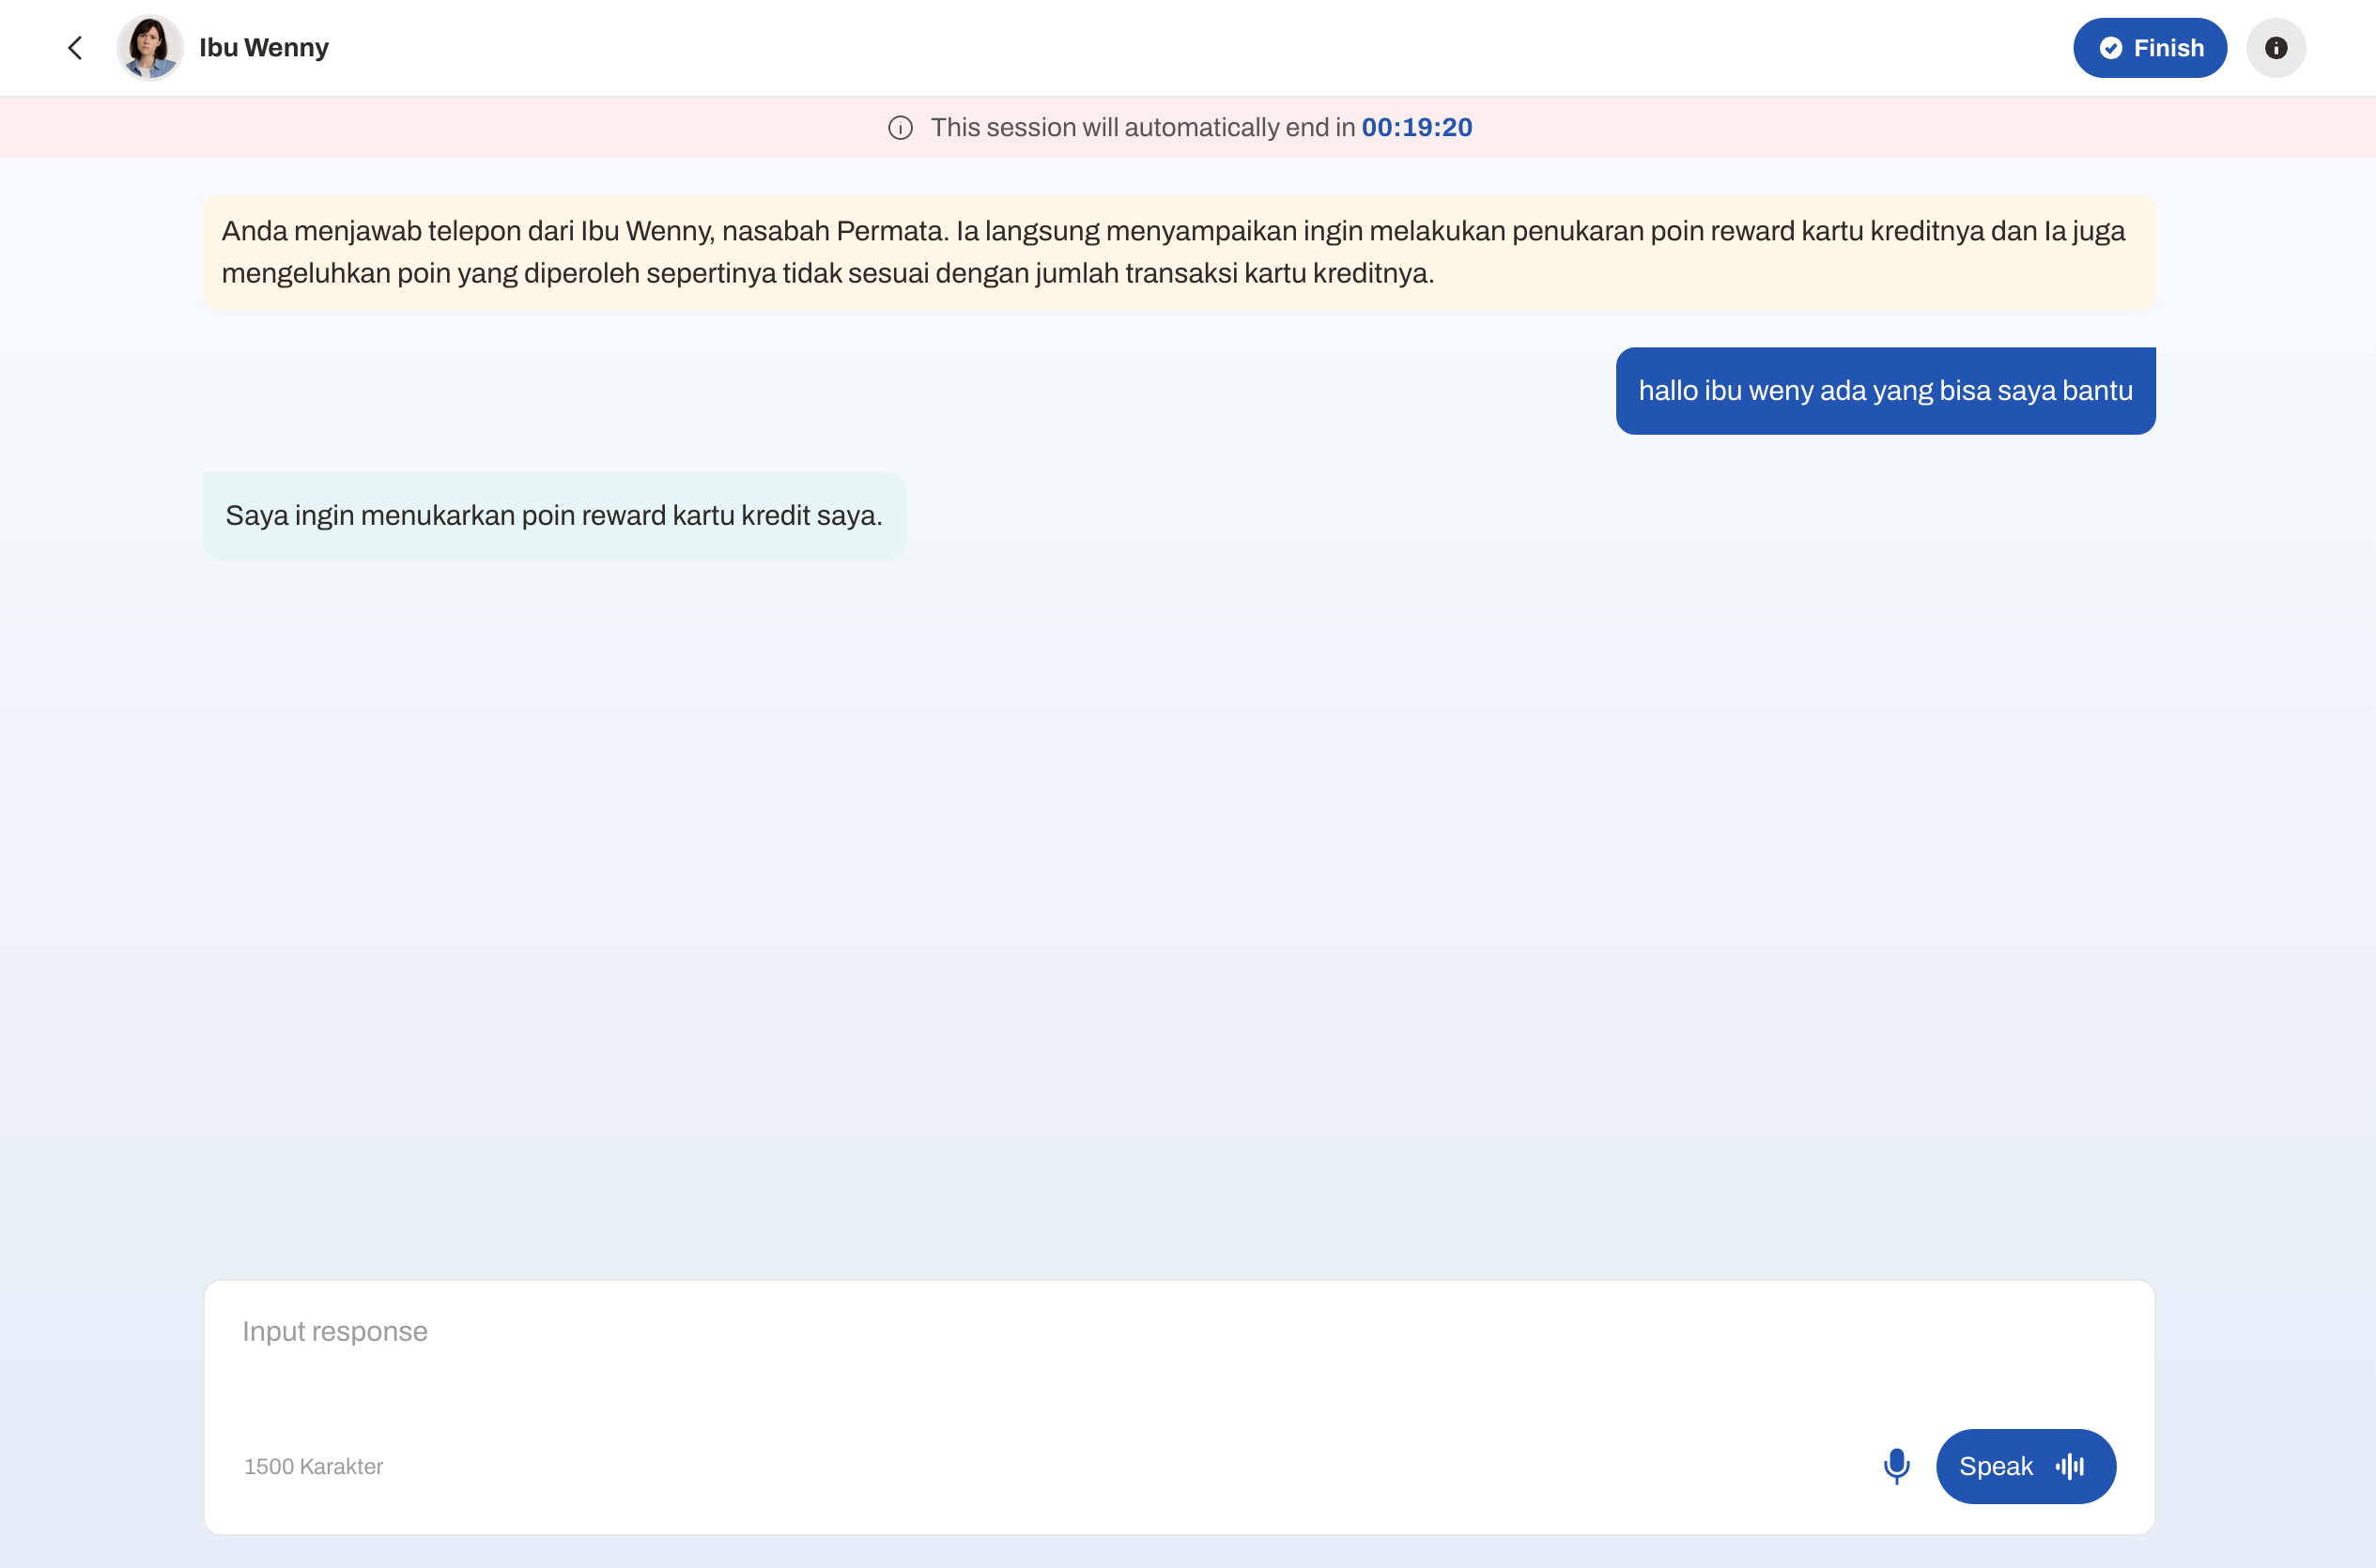
Memegang penuh frontend/streaming UX secara end-to-end, ditambah interface CMS yang digunakan untuk mengunggah dan mengelola dokumen sumber. Streaming awalnya dirilis lewat WebSocket (masih menopang beberapa fitur roleplay legacy), lalu flow yang lebih baru dipindahkan ke SSE. Tantangan terbesarnya adalah melakukan scaling pada streaming layer di bawah concurrent load — menjaga respons token-by-token secara real-time tetap stabil seiring naiknya penggunaan, sekaligus memastikan rendering markdown benar seutuhnya di chat UI.
Dampak
Hasilnya terasa lebih seperti percakapan alih-alih search box — jawaban langsung masuk secara streaming dan tetap berpijak pada konten pembelajaran milik Inspigo sendiri, bukannya melantur ke respons umum tanpa dasar. Dibangun bersama tim beranggotakan 5 orang; peak usage mencapai ribuan percakapan per hari.